事情是从六月开始的
那天例行巡检,在一台 GPU服务器 上敲了条常规检查命令:
|
1 |
nvidia-smi -i 2 -q | grep -A 20 "ECC Errors" | head -40 |
输出里有一行,数字不怎么好看:
|
1 2 3 |
Aggregate DRAM Correctable : 7 DRAM Uncorrectable : <span class="r">269</span> |
269。不是 269 次"检测到但修好了",是 269 次压根修不好。
说白了,GPU 的显存里已经有 269 个位置,读出来的数据是错的,而且 ECC 纠错机制拿它没办法。这种错误有个正经名字叫 Uncorrectable ECC Error,或者按位宽叫 DBE(Double Bit Error)。它会干什么?让正在跑的训练任务莫名其妙崩掉,或者更糟——算出一堆看着像模像样、其实是垃圾的结果。
所以结论很直接: 这颗卡得换。
但麻烦的地方在于,换不了。报告了厂商,查了资料,NVIDIA 和整机厂商的 RMA 门槛是 512 个。当时是 269,还差一半多。于是这颗卡就卡在一个很微妙的状态里:已经确定坏了,但还没坏够。重启接着用。
为什么监控大盘看不见它
这是整件事最有意思的地方,也是我踩过的坑。
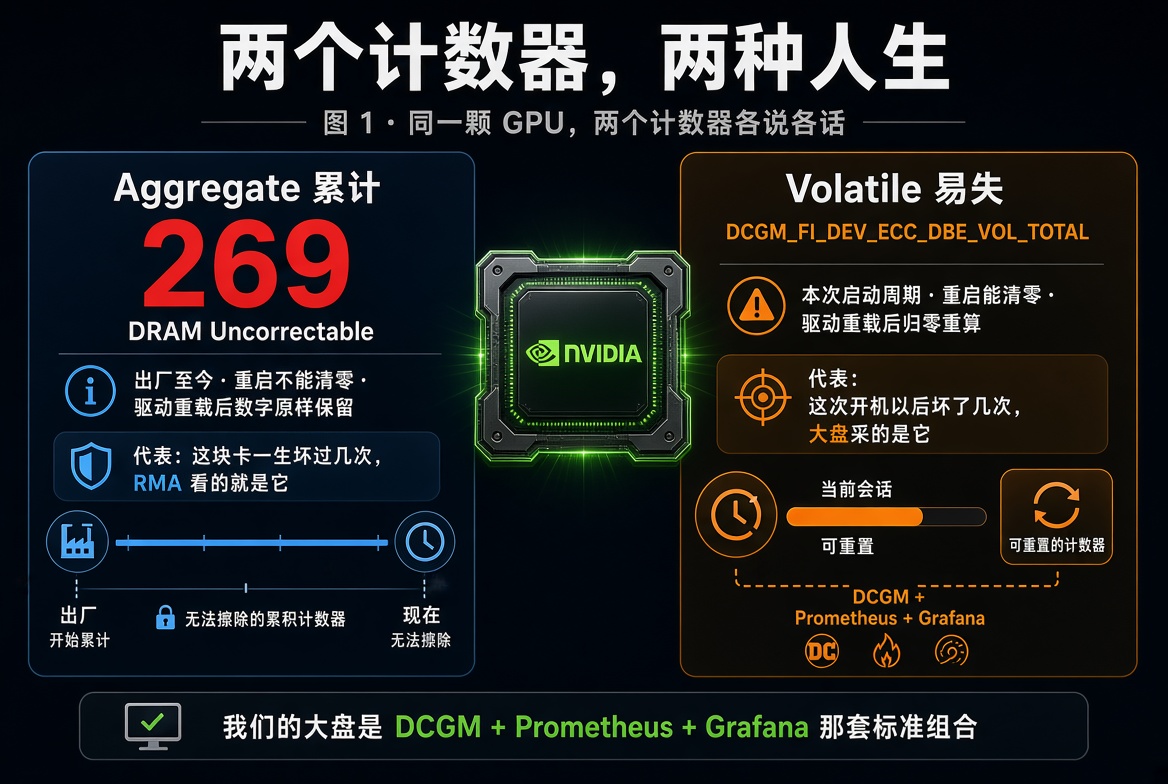
我们的大盘是 DCGM + Prometheus + Grafana 那套标准组合。它采集的指标叫 DCGM_FI_DEV_ECC_DBE_VOL_TOTAL。名字里那个 VOL,是 volatile 的缩写。而 nvidia-smi 里那个 269,出自 Aggregate 分类。两个词,两个完全不同的计数器。
两个计数器,两种人生
Aggregate
累计 · 出厂至今,重启能清零吗,不能,驱动重载后,数字原样保留
代表什么,这块卡一生坏过几次,RMA 看的就是它
DRAM Uncorrectable : 269
Volatile
易失 · 本次启动周期重启能清零吗,能,驱动重载后,归零重算,
代表什么,这次开机以后坏了几次大盘采的是它
DCGM_FI_DEV_ECC_DBE_VOL_TOTAL
图 1 · 同一颗 GPU,两个计数器各说各话
于是就有了那个经典场面:
- 错误发生在上一次启动周期之前(或者驱动加载之前);
- 当前的 Volatile 计数器是 0;
- 大盘忠实地采集了这个 0,安安静静,一片祥和。
而 Aggregate 里那 269,一直躺在那里,谁也看不见。
在现代 DCGM + Prometheus 的实践里,该盯的告警指标是 ecc.errors.uncorrected.volatile.total。这个值正常就该是 0。只要不是 0,说明问题就发生在当前这个运行周期,是现役风险,得当回事。
先分清 SBE 和 DBE,不然会白紧张
ECC 错误不是一种东西,分两类,处理态度完全不同:
能被 ECC 自动纠正,程序无感
处理态度
预警信号
计数上涨说明
颗粒在退化,该开始关注了
Uncorrectable · 多比特 DBE
纠不回来,数据已经错了
处理态度
必须立即处理
后果
任务崩溃,或静默算出错误结果
图 2 · SBE 是黄灯,DBE 是红灯——而静默的数据错误比崩溃更难查
所以看到 DRAM Correctable: 7 不用慌,看到 DRAM Uncorrectable: 269 就得认真了。
那重启一下能清掉吗
不能。这个得说清楚,因为很容易误解。
nvidia-smi --reset-ecc-errors=0 这条命令确实能"清零",参数 0 指 Volatile,1 指 Aggregate。但它清的只是计数器上的数字,不是故障本身。硬件该坏还是坏,任务该崩还是崩。
而且真正的内存修复机制——Page Retirement 和 Row Remapping——都需要重启 GPU 才能生效。所以这里有个很容易搞混的点:重启能让修复动作落地,但不会让"这颗卡有毛病"这件事消失。
然后就是等,以及每隔一阵记一笔
从六月到九月,这个数字的成长史大概是这样:
DRAM Uncorrectable 的增长轨迹512 · RMA 门槛
269
475
476
499
500
6月
07-27
08-26
09-03
09-03 夜
中间那段几乎平了(475→476 只涨了 1),直到再次上强度压测才开始跳。这和"掉卡"的触发方式有关——它不是匀速坏的。
图 3 · 从 269 到 500:不是线性增长,而是压测一上强度就跳
中间有个细节挺说明问题:8 月底那次只涨了 1(475 → 476)。当时还以为是不是稳住了,后来才想明白——这种错误不是均匀冒出来的。平时负载轻,它就安静待着;一旦上强度压测、把卡往极限里推,才会触发新的错误。
换句话说,这颗卡是被压出来的。
动手:把它接进看板
既然它不在标准指标里,那就自己造一个。思路很简单, 三步:
- 写个脚本,定期跑
nvidia-smi,把 Aggregate 里的 DBE 数字抠出来; - 按 node_exporter 的 textfile 格式落盘;
- 让 node-exporter 把这个目录读进去,Prometheus 自然就能抓到。
第一步的脚本,核心就是一段 awk:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 |
#!/bin/bash OUTFILE="/var/lib/node_exporter/textfile/nvidia_ecc.prom" TMPFILE="${OUTFILE}.$$" mkdir -p "$(dirname "$OUTFILE")" # 获取节点名(优先使用 HOSTNAME 环境变量,否则用 hostname 命令) NODE="${HOSTNAME:-$(hostname)}" nvidia-smi -q -d ECC | awk -v node="$NODE" ' /GPU [0-9a-fA-F:]+\./ { gpu_idx++ } /Aggregate/ { a = 1 } /DRAM Uncorrectable/ && a { printf("nvidia_ecc_dram_uncorrectable_aggregate{node=\"%s\", gpu=\"%d\"} %s\n", node, gpu_idx-1, $NF) a = 0 } ' > "$TMPFILE" mv "$TMPFILE" "$OUTFILE" chmod 644 "$OUTFILE" |
有个小坑值得记一下:nvidia-smi -q -d ECC 的输出里,Volatile 和 Aggregate 两个段都有 DRAM Uncorrectable 这一行。所以 awk 里那个 a 标志位是必需的——只在看到 Aggregate 之后才取值,不然会抓到 Volatile 的 0。
跑完长这样:
|
1 2 3 4 5 6 7 8 9 |
nvidia_ecc_dram_uncorrectable_aggregate{node="r3n2", gpu="0"} 0 nvidia_ecc_dram_uncorrectable_aggregate{node="r3n2", gpu="1"} 0 nvidia_ecc_dram_uncorrectable_aggregate{node="r3n2", gpu="1"} 0 nvidia_ecc_dram_uncorrectable_aggregate{node="r3n2", gpu="2"} 20 nvidia_ecc_dram_uncorrectable_aggregate{node="r3n2", gpu="2"} 496 nvidia_ecc_dram_uncorrectable_aggregate{node="r3n2", gpu="3"} 0 nvidia_ecc_dram_uncorrectable_aggregate{node="r3n2", gpu="3"} 0 nvidia_ecc_dram_uncorrectable_aggregate{node="r3n2", gpu="4"} 0 nvidia_ecc_dram_uncorrectable_aggregate{node="r3n2", gpu="4"} 0 |
第二步,用 Ansible 铺到所有 GPU 节点上:建目录、发脚本、加 cron(每两小时跑一次)。
|
1 2 3 4 5 |
ansible-playbook deploy-ecc-collector.yaml <span class="c"># 或者手动几行搞定</span> ansible gpu-nodes -m file -a "path=/var/lib/node_exporter/textfile state=directory owner=nobody group=nogroup mode=0755" ansible gpu-nodes -m shell -a 'echo "25 */2 * * * /usr/local/bin/ecc-collect.sh" | crontab -' |
第三步是关键的改动:node-exporter 默认不读 textfile 目录,得把 collector 打开,并且把这个目录挂进去。
|
1 2 3 4 5 6 7 8 9 10 11 12 |
<span class="c"># DaemonSet 里加两处</span> args: - --collector.textfile.directory=/var/lib/node_exporter/textfile volumeMounts: - mountPath: /var/lib/node_exporter/textfile name: textfile readOnly: true volumes: - hostPath: path: /var/lib/node_exporter/textfile type: DirectoryOrCreate name: textfile |
这里也有个容易漏的点:宿主机上的目录权限得让容器里的 nobody(65534)读得到,否则 node-exporter 起了但读不到文件,指标依然是空的。
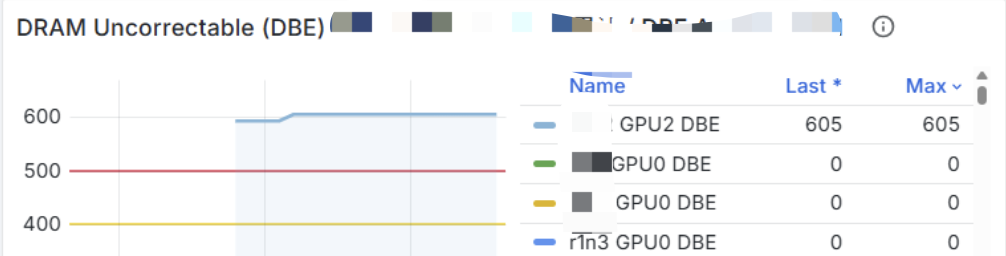
看板上终于出现了一条曲线,能直接看到每台机器、每颗 GPU 的 Aggregate DBE 计数。不用再一台台手动敲命令了。
现在的位置
500 / 512。还差 12 个。
就等下一次强力压测——按之前的规律,把卡推到极限,大概就会再掉几个,凑够数就能提 RMA 了。
说不上来这是不是一种奇怪的等待。但我们盯着这条曲线看了三个月,从 269 看到 500,某种程度上也算陪着这颗卡走完了它的后半程。
后记: 9月 某天,终于上了 512了,正式提 RMA。
附录:RMA 的触发条件
NVIDIA 关于显存行重映射(row remapping)的 RMA 政策里,触发"需要更换"的条件是以下任意一条:
- 某个 bank 已经有 8 行不可纠正错误被重映射过,之后又尝试重映射新的不可纠正错误;
- 对已经重映射过的行再次尝试重映射(这种情况可以少于 8 次总重映射);
- 累计 512 次不可纠正错误的重映射。
官方文档在这一份:GPU DRAM Memory RMA Policy(GPU 显存错误管理指南)。提 RMA 之前,通常还会被要求跑一遍 Field Diagnostics Tool, 把结果一起交上去,话说这个 报告也很费事,有空再考虑写写。
大盘绿不代表机器好。Volatile 看的是"这次开机之后",Aggregate 看的是"这块卡这一生"。要盯硬件寿命,就得盯 Aggregate——而它不在默认指标里, 得自己接。
