故事的开始很普通。上午,有人反馈:某个容器里的 Python 脚本读文件直接抛IO异常,让查下 DDN(lustre)。
|
1 2 3 4 |
$ python -c "open('.../pytest-9.1.1.dist-info/entry_points.txt','rb').read(200)" Traceback (most recent call last): File "<string>", line 1, in <module> OSError: [Errno 5] Input/output error |
同一个目录下的另一个文件,读起来却完全正常。
|
1 2 |
$ python -c "open('.../pytest-9.1.1.dist-info/top_level.txt','rb').read(200)" # 正常返回 |
这种"一半好一半坏"的现象最容易带偏人。现场迅速形成了三种猜想:
- 权限问题——uid/gid 对不上,容器里某个用户没权限;
- 存储坏了——DDN 后端出问题,数据损坏;
- 容器坏了——旧容器有 bug,重建就好。
后来证明:三个都不对。真正的答案是第 4 个——InfiniBand 网络在某几分钟里抖了一下,导致一系列后续故障。
第一现场:一台节点上的完整证据链
出问题的节点(下称 node-a)在 08:31 到 08:46 这个窗口内表现异常。我们先看整体结构。
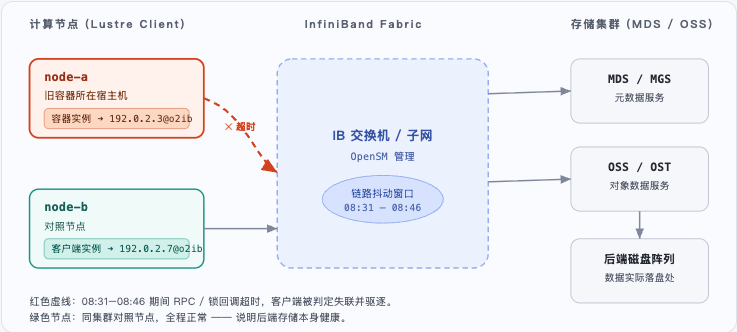
图 1 · 拓扑与故障路径:问题出在客户端与 Fabric 之间
证据一:OST 没有进入只读
排查的第一件事是确认存储后端本身的状态——因为"存储坏了"是最吓人的猜想。
|
1 2 3 |
$ lctl get_param obdfilter.*.readonly obdfilter.lustrefs-OST0000.readonly=0 obdfilter.lustrefs-OST0001.readonly=0 |
readonly=0 意味着 OSS 数据层从未降级为只读。 Lustre 只有在后端文件系统检测到严重错误时才会切只读。它是 0,说明磁盘阵列和数据层是健康的。
存储后端健康,"DDN 坏了"这条猜想初步排除。
证据二:服务器自己的 IB 网卡进了 recovery
这是整条证据链里最关键的一行。在内核日志里:
|
1 2 3 |
08:39:12 LNet: <span class="y">1 local NIs in recovery</span> (showing 1): 192.0.2.101@o2ib 08:39:50 LNet: kiblnd_check_conns() <span class="r">Timed out tx</span> 08:40:28 LNet: kiblnd_check_conns() Timed out tx (Skipped 2 previous similar message) |
注意 local NIs 这个词——local,指的是服务器自己。也就是说,存储服务器自身的 IB 网卡进了 recovery 状态。这不是客户端单方面的问题,是服务器端的 o2ib 链路发生了抖动或断开重连。
紧接着的 kiblnd_check_conns() Timed out tx 来自 o2iblnd(InfiniBand 的 LNet 驱动层),是传输层连接超时的直接证据。它和文件权限、uid/gid 没有任何关系。
证据三:客户端的 import 状态是 EVICTED
从服务器视角看完,再切到客户端视角。node-b 上一度能直接复现问题:
|
1 2 3 4 5 |
$ lfs check servers | grep -i OST000f lfs check: error: check 'lustrefs-OST000f-osc-...': Cannot send after transport endpoint shutdown (108) # 对照节点 node-c 上同一条命令 lustrefs-OST000f-osc-... active。 |
而真正把状态钉死的,是客户端 import 参数里的这一行:
|
1 2 3 4 5 6 7 8 9 10 11 |
$ lctl get_param osc.lustrefs-OST000f-osc-....import import: name: lustrefs-OST000f-osc-... target: lustrefs-OST000f_UUID state: EVICTED # ← 关键 import_flags: [ invalid, replayable, pingable, connect_tried ] connection: nids_stats: "192.0.2.114@o2ib": { connects: 514, replied: 514, ... sec_ago: 73140 } current_connection: "192.0.2.114@o2ib" idle: 73140 sec |
这里有三个信息量很大的细节:
state: EVICTED——客户端被服务端驱逐,所有发往该 OST 的操作都会失败;import_flags里有invalid——连接已失效;replied: 514——最后那次连接是收到了应答的,应答内容就是"你被驱逐了"。说明那一刻网络还通,是服务端先动了手。
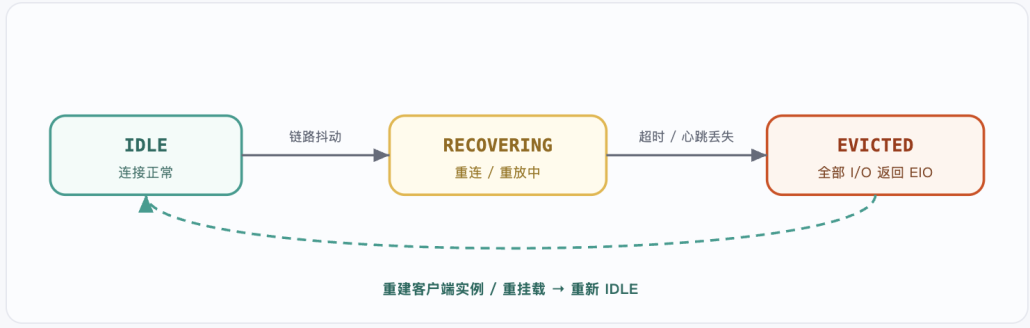
图 2 · 客户端 import 状态机:修复路径是重建实例,不是改权限
把时间线拼回来
单独看每行日志没什么感觉,按时间顺序排就一目了然了。
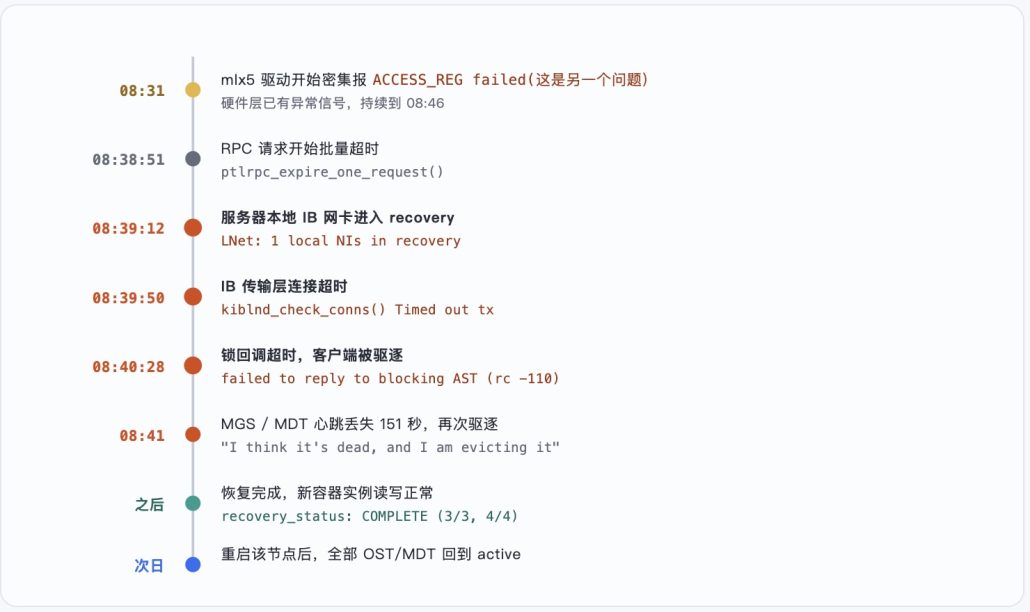
图 3 · 时间线复原:从驱动异常到客户端被驱逐,再到恢复
为什么"新容器没问题"反而帮了倒忙
现场最容易被当成结论的一句话是:"我重建了个容器,读写就正常了,所以是旧容器的问题。"
这句话逻辑上没错,但它证明不了"旧容器本身有缺陷"。因为 Lustre 的驱逐是客户端实例级别的:
| 对象 | 状态 | 读写结果 |
|---|---|---|
| 旧容器(对应被驱逐的客户端实例) | 已被服务端驱逐,锁与缓存状态被撤销 | 全部 I/O 返回 EIO |
| 新容器(全新客户端实例) | 网络已恢复,重新挂载、重新连接 | 正常 |
新建容器时,网络抖动窗口已经过去了,它自然一切正常。这只能说明问题窗口已经结束,不能说明旧容器有 bug。
为什么是 EIO 而不是 Permission denied权限不足会返回
Permission denied。而Input/output error(rc -5 / -EIO)是客户端被驱逐后,Lustre 对 OST/MDT 的后续操作统一返回的错误码。二者含义完全不同,这也是排除权限猜想的直接依据。
另一台节点的独立佐证
同期 node-b 上也出现了同类现象,而且更"教科书":先是 lock enqueue 失败,然后是脏页被丢弃。
|
1 2 3 4 |
Sep 20 18:26:54 LustreError: lustrefs-OST000f-osc-...: operation ost_write to node 192.0.2.114@o2ib <span class="r">failed: rc = -107</span> Sep 20 18:26:54 LustreError: lustrefs-OST000f-osc-...: <span class="r">This client was evicted by lustrefs-OST000f</span>; in progress operations using this service will fail. Sep 20 18:26:55 LustreError: ldlm_resource_complain() ... refcount nonzero (1) after lock cleanup; forcing cleanup. |
还有一条容易被忽视、但含义很重的日志:
|
1 |
<span class="r">dirty page discard</span>: ...: [0x200006ae1:0x1ff39:0x0]// <span class="y">may get corrupted</span> (rc -5) |
dirty page discard 意味着客户端有尚未刷回存储的脏页被丢弃。这是真实的数据风险点——不是存储坏了,而是网络中断导致写缓存里的数据没能落盘。
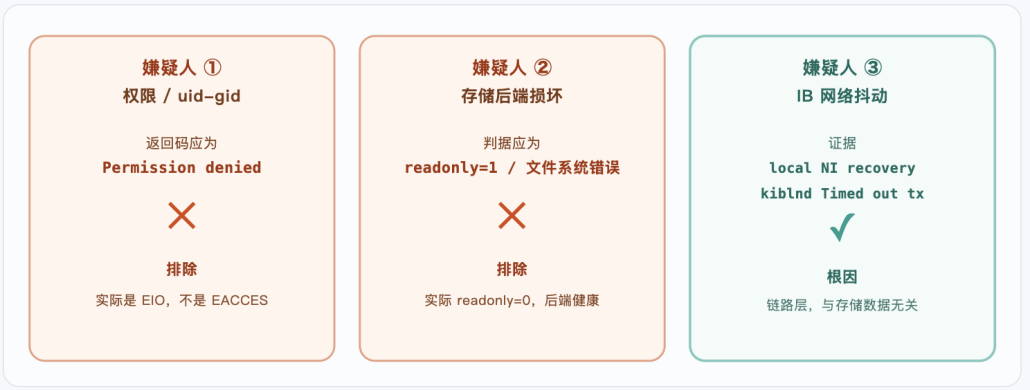
图 4 · 排除法:三个嫌疑人,只有第三个对得上全部证据
收网:证据链的完整表述
把所有片段串成一条链:
08:31 起,HCA 驱动层出现密集异常(mlx5 ACCESS_REG failed),持续约 15 分钟,指向固件/寄存器交互异常;
08:38:51 起 RPC 请求批量超时;
08:39:12 存储服务器本地 IB 接口进入 recovery;
08:39:50 / 08:40:28 连续出现 IB 传输层连接超时;
08:40:28 客户端因锁回调超时(rc -110 / ETIMEDOUT)被 OST 驱逐;
08:41 MGS/MDT 又因 151 秒无心跳将其驱逐。
全程 OST readonly=0,无文件系统错误。根因是 IB 链路/驱动层异常,不是 DDN 存储后端,也不是容器权限。
同时要诚实标注一个未完全闭合的点:证据包里的 IB 端口计数器(link_downed、symbol_error、link_error_recovery)在采集时全是 0,hw_counters 也是空文件。lctl 日志中只有 drop_count: 5。
这意味着:物理链路本身没有经历 Link Down,抖动的成因更可能在固件/驱动交互层(呼应 08:31 的 mlx5 报错),而不是线缆或光模块。要彻底闭合,还需要看交换机端口计数器和同一 Fabric 上其他节点的同期表现——但就目前证据,方向已经明确。
经验小结
- 先看错误码,再看错误信息。
EIO和EACCES指向完全不同的层,一个字母的差别就是两个排查方向。 - 区分"服务端健康"和"链路健康"。
readonly=0只证明数据层没事,不证明客户端能连上。 - "重建就好了"不是归因。 它只说明故障窗口结束了。要问的是:窗口内发生了什么。
- 警惕被驱逐后的连锁反应。 锁失效、脏页丢弃(可能损坏)、资源未释放(refcount 异常),都发生在驱逐之后,是结果不是原因。
- 取证要趁早。 计数器是累加的,但很多状态是易失的;本文的证据包能成型,靠的是在故障后尽快系统性采集。
附录:一键证据收集清单
排查这类问题最怕"知道要查什么,但当时没存下来"。以下是在客户端节点上一次值得跑完的采集项:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 |
# 1) 客户端与存储的连接状态(最关键) lctl get_param osc.*.import | grep -E "state|nids_stats|idle|replied" lctl get_param mdc.*.import | grep -E "state|idle" lfs check servers # 2) 服务端数据层健康度 lctl get_param obdfilter.*.readonly lctl get_param *.*.recovery_status # 3) 内核日志中的 IB / LNet / 驱逐事件 journalctl -k --since "$START" --until "$END" --no-pager -o short-precise \ | grep -iE "kiblnd|o2iblnd|LNet|evict|LustreError|mlx5" # 4) IB 设备与端口状态 ibstat for f in /sys/class/infiniband/*/ports/*/counters/*; do echo "$f: $(cat $f)"; done | grep -viE ": 0$" # 5) 驱动版本(判断是否需要匹配固件) modinfo mlx5_core | head -5 ibstat -s | grep -E "CA '|Firmware" |
把这些输出连同时间窗口一起打包留档,下次再遇到"是不是存储坏了"的争论时,就不需要靠猜了。
—— 本文由某调试中的自建AI模型整理 ——

文章评论